Comment ChatGPT choisit ses sources ?
Lire la transcription de la vidéo +
[0:00] Comment ChatGPT choisit ses sources ? Il ne lit pas le web au hasard. Quatre règles, observées sur des millions de réponses.
[0:06] Une question devient plusieurs recherches. « Quelle agence pour vendre dans le 11e ? » devient « agence immobilière Paris 11 avis », « prix », « site officiel », « 2026 ». Des mots que vous n'avez pas tapés.
[0:15] Trois moteurs : SerpAPI pour les résultats Google, Bing pour les images, Labrador, l'index maison d'OpenAI, pour le web, les actualités et Wikipedia.
[0:24] La source d'origine avant le résumé. En six mois, PubMed est passé de la 64e à la 4e place, Reddit d'une réponse sur 5 à une sur 43. Vos prix, vos horaires, votre adresse doivent être sur votre site.
[0:33] Il cherche en anglais, même pour une question en français : 43 % des sous-requêtes. Une page clé en anglais peut faire la différence.
[0:42] Les partenaires et les sources établies passent devant. Sur 359 médias cités depuis la France, 9 reçoivent la moitié du trafic. Le Monde, partenaire d'OpenAI, plus d'un clic sur quatre.
[0:50] Ce que ça change : des faits en clair sur vos pages, les bons mots, une version anglaise des pages clés, et être cité là où ChatGPT lit déjà. Le guide complet est sur kokonseo.com.
Quand ChatGPT recommande une entreprise, il ne l'a pas tirée de sa mémoire. Il a lancé une recherche, lu des pages, et retenu celles qui lui semblaient fiables. La question pour une entreprise n'est donc pas « comment plaire à ChatGPT », mais « quelles pages lit-il, et pourquoi celles-là ». Cet article répond avec ce que les données montrent en 2026, études nommées, et traduit chaque constat en action. Il complète notre guide complet pour apparaître sur ChatGPT, qui donne la méthode de bout en bout.
ChatGPT ne lit pas le web au hasard
Première chose à comprendre : la plupart des réponses de ChatGPT ne déclenchent aucune recherche. Sur 66,6 millions de réponses analysées par Ahrefs en août et septembre 2026, seules 14,4 %, soit une sur sept, contenaient des recherches web. Les autres viennent de ce que le modèle a appris à l'entraînement. Mais dès que la question est locale, commerciale ou récente (« quelle agence », « quel prix », « quel avis »), la recherche se déclenche. Et c'est précisément là que se jouent les recommandations d'entreprises.
Quand il cherche, ChatGPT suit des règles observables. Quatre ressortent des études publiées en 2026, et chacune a une conséquence directe pour une entreprise qui veut être citée.
Règle 1 : une question devient plusieurs recherches
ChatGPT ne tape pas votre question dans un moteur. Il la découpe en sous-requêtes, ce que les spécialistes appellent le query fan-out. Ahrefs en a analysé 15 millions : les réponses qui cherchent lancent en moyenne 1,6 sous-requête, et ces sous-requêtes ajoutent des mots qui ne figuraient pas dans la question.
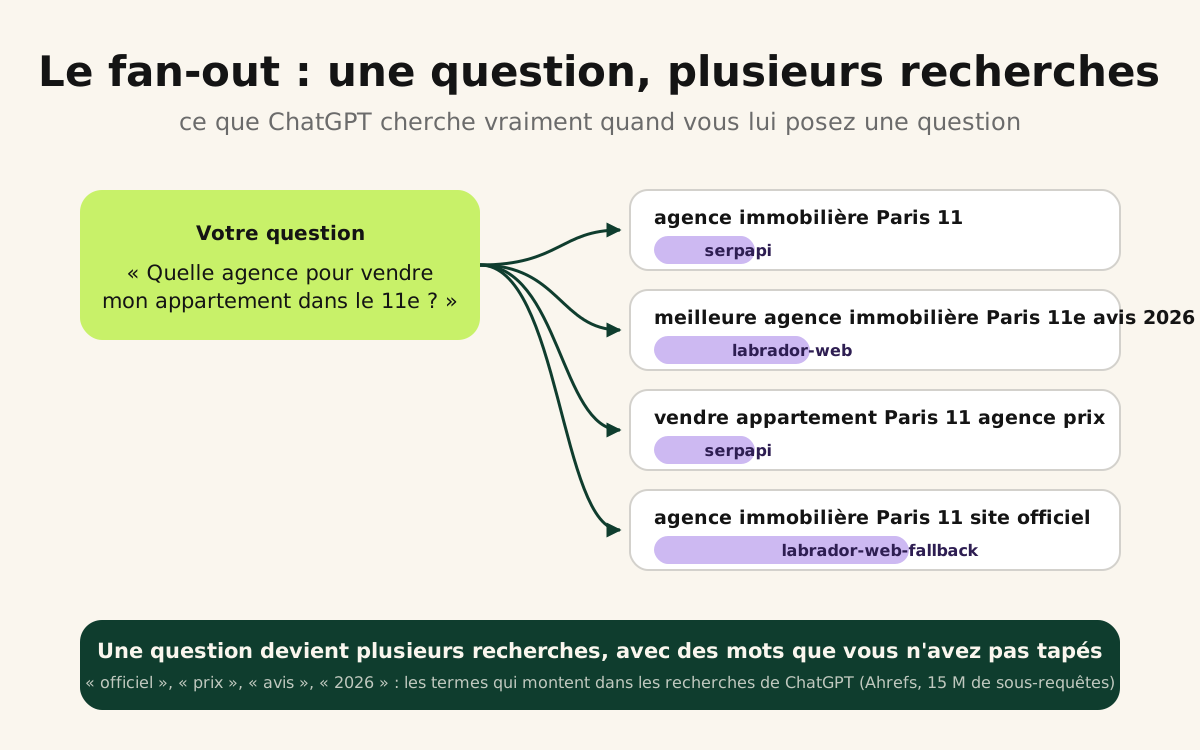
Les mots ajoutés disent ce que ChatGPT cherche à vérifier. En septembre 2026, « 2026 » apparaissait dans 22,9 % des sous-requêtes anglaises, « officiel » dans 13,1 %, « prix » dans 8,9 % (en hausse de 47 % en un mois), et « avis » progressait d'un tiers. Dans 6,8 % des cas, la sous-requête vise un site précis avec l'opérateur site:, et trois fois sur quatre ce site est celui d'une marque.
Conséquence : une page n'a pas à répondre à la question telle que votre client la pose. Elle doit répondre aux sous-requêtes que ChatGPT en tire. « Agence immobilière Paris 11e : tarifs, avis et équipe, site officiel » est une page que le fan-out trouve. « Bienvenue chez nous » n'en est pas une.
Règle 2 : trois moteurs, dont Google par la bande
On a longtemps écrit que ChatGPT cherchait « via Bing ». Les requêtes internes du produit montrent autre chose. La clé search_engine prend trois familles de valeurs.
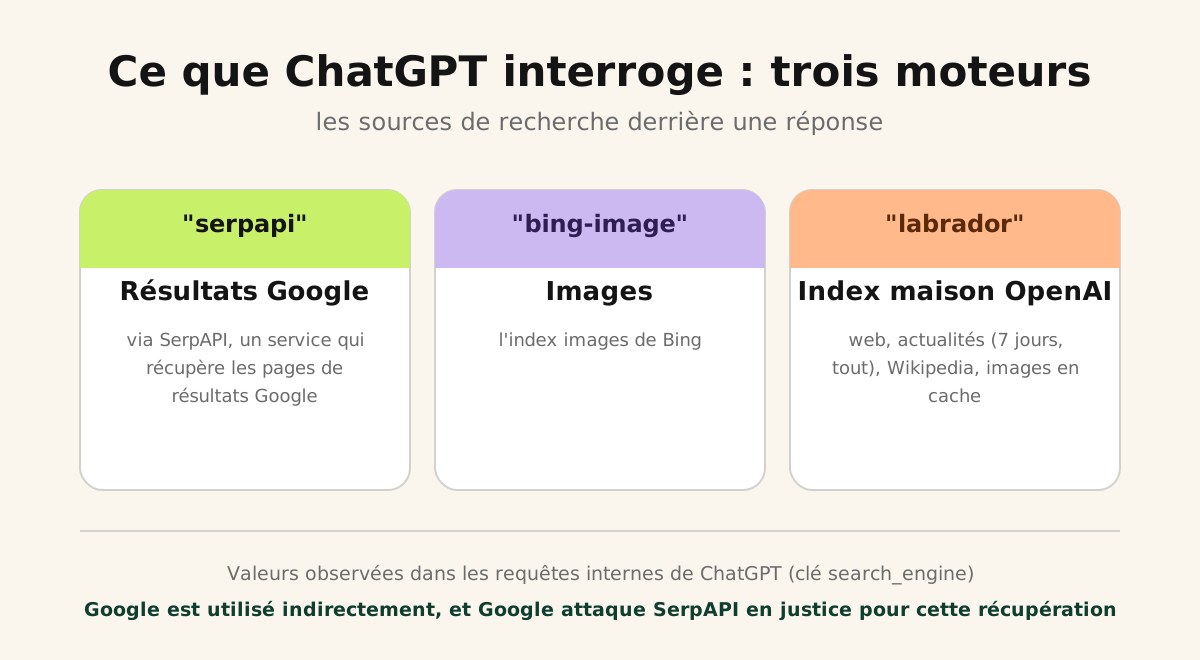
- serpapi : SerpAPI est un service tiers qui récupère les pages de résultats Google. ChatGPT s'en sert pour une partie de ses recherches, ce qui veut dire qu'une bonne position Google alimente indirectement ses réponses. Google a engagé une action en justice contre SerpAPI pour cette récupération.
- bing-image : l'index images de Bing, utilisé quand la réponse appelle des visuels.
- labrador : l'index maison d'OpenAI, décliné en plusieurs variantes (web, web-fallback, actualités sur 7 jours ou en totalité, Wikipedia, images en cache). C'est lui qui porte l'essentiel des recherches sur le web et l'actualité.
Pour une entreprise, la lecture est simple : être bien placé sur Google aide, mais ne suffit pas. Labrador a son propre index, et ce qu'il y trouve dépend de ce que vos pages disent en clair, pas de votre classement.
Règle 3 : la source d'origine avant le résumé
C'est le mouvement le plus net de l'année. Entre mars et septembre 2026, sur 2,4 à 3,8 millions de réponses ChatGPT par mois aux États-Unis, Ahrefs a vu les sources primaires monter et les intermédiaires reculer.
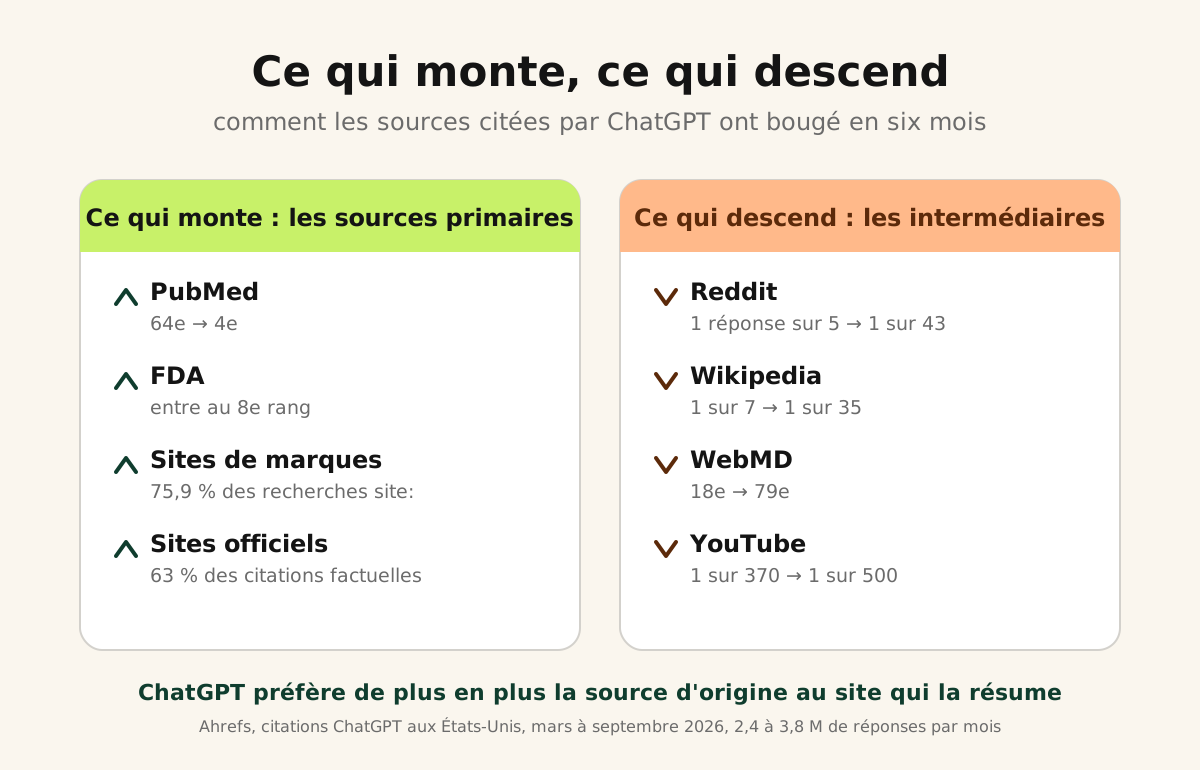
PubMed est passé de la 64e à la 4e place des domaines les plus cités, la FDA est entrée au 8e rang. Dans le même temps, Reddit a chuté de 88 % (d'une réponse sur cinq à une sur 43), Wikipedia de 80 % (d'une sur sept à une sur 35), et les sites d'explication comme WebMD ou Healthline ont décroché. Sur les questions factuelles (prix, caractéristiques, coordonnées), 84,4 % des réponses citent au moins une source officielle, et les sites officiels font 63,4 % des citations.
Conséquence : si vos prix, vos horaires, votre adresse ou votre zone d'intervention ne sont lisibles que chez un tiers (annuaire, comparateur, article), ChatGPT ira les chercher chez ce tiers et le citera lui. La page d'origine, c'est la vôtre : mettez-y les faits en clair.
Règle 4 : il cherche en anglais, même en France
Peec AI a analysé plus de 10 millions de prompts et 20 millions de sous-requêtes, en ne gardant que les cas où la langue de la question correspond au pays de l'utilisateur. Résultat : 43 % des sous-requêtes pour des questions non anglophones sont faites en anglais, et chaque session analysée contenait au moins une recherche sur le web anglais. Aucune langue n'est en dessous de 60 % de sessions concernées.
Les exemples de l'étude parlent d'eux-mêmes : une question en allemand sur des éditeurs de logiciels allemands qui ne renvoie aucune entreprise allemande ; une question en polonais sur les sites d'enchères où Allegro, leader du marché, est absent ou enfoui derrière eBay ; une question en espagnol sur les cosmétiques sans aucune marque espagnole. L'explication avancée : les pages anglaises ont plus de liens et de citations, donc elles sont plus faciles à juger fiables, et la moitié du web est en anglais.
Conséquence : une entreprise française peut dominer son marché et rester invisible dans ChatGPT. Pas besoin de traduire tout le site : une version anglaise des deux ou trois pages clés et une mention dans un comparatif en anglais suffisent souvent à exister dans la moitié des recherches que vous ratez aujourd'hui.
Les partenaires d'OpenAI et la concentration des sources
Deux faits complètent le tableau. Le premier vient d'Ahrefs : parmi les 200 domaines les plus cités par ChatGPT, la part des éditeurs ayant signé un accord avec OpenAI est passée de 7,5 % en mars à 15,8 % en juillet 2026, avant de se stabiliser autour de 12,5 %. Les partenaires sont lus et cités davantage.
Le second vient de l'INA. La Revue des médias a mesuré, avec les données SimilarWeb, où vont les clics que ChatGPT envoie vers la presse depuis la France en 2025 : 9,9 millions de visites, dont plus d'un quart (25,9 %) pour Le Monde, premier média français partenaire d'OpenAI depuis mars 2024. Sur 359 domaines de médias cités, 9 reçoivent la moitié du trafic et 57 en reçoivent 80 %. Les 259 autres se partagent 11 % des clics.
Pour une entreprise, ça dit où une mention tierce pèse le plus : dans les titres que ChatGPT lit déjà. Une interview dans Le Monde ou Les Échos vaut plus, pour la visibilité IA, qu'un article dans un média qu'il ne consulte jamais. Et dans chaque secteur, les annuaires et comparatifs qu'il consulte jouent le même rôle de passage obligé.
Ce que ça change pour une entreprise
Quatre règles, quatre actions. Aucune ne demande un budget média ni une refonte.
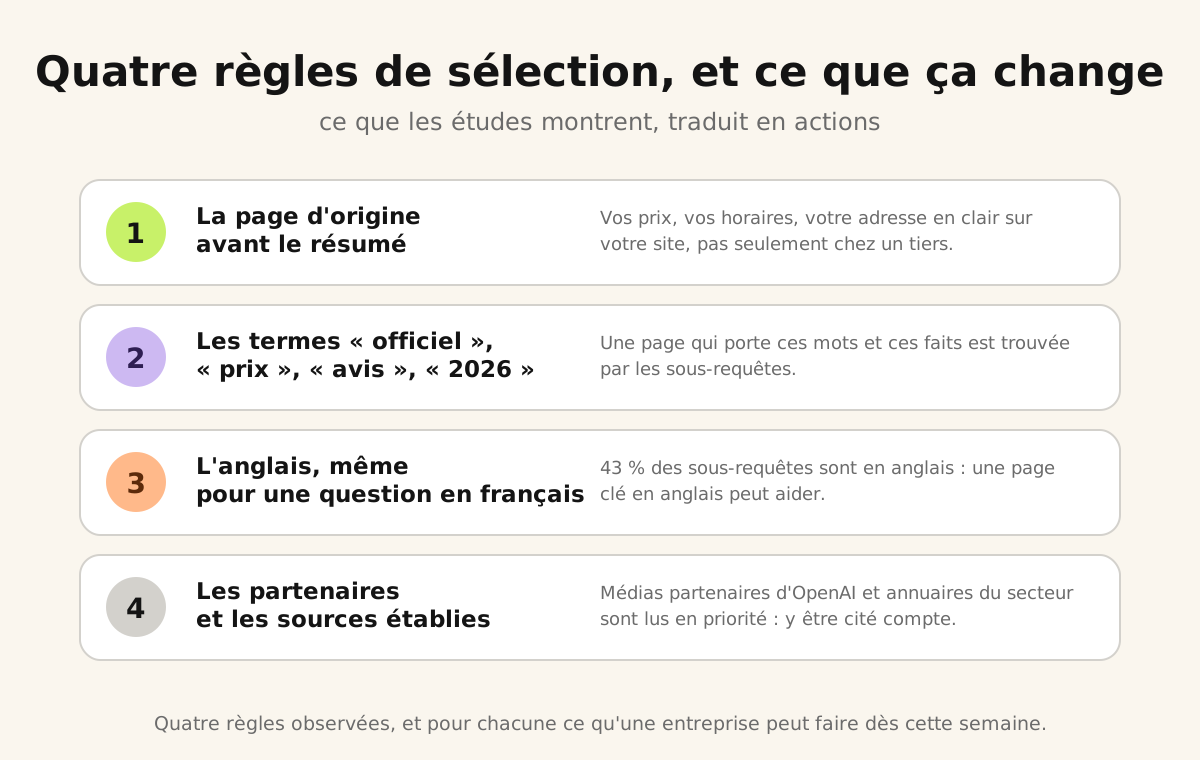
- Mettre les faits en clair sur vos propres pages. Prix, horaires, adresse, zone, équipe, année de création. En texte, pas en image ni en PDF. C'est la source d'origine que ChatGPT préfère désormais.
- Écrire pour les sous-requêtes, pas pour la question. Vos pages clés doivent porter les mots que le fan-out ajoute : « tarifs », « avis », « site officiel », l'année en cours, le nom de la ville ou du quartier.
- Exister en anglais sur deux ou trois pages. Qui vous êtes, ce que vous faites, combien ça coûte. Et viser une mention dans un comparatif anglophone de votre secteur.
- Être cité là où ChatGPT lit déjà. Les annuaires et comparatifs de votre secteur, et les médias partenaires d'OpenAI quand c'est accessible. Une mention dans une source que ChatGPT ne consulte pas ne sert à rien pour la visibilité IA.
Ces quatre actions sont le cœur des leviers 1, 2, 3 et 6 de notre guide complet pour apparaître sur ChatGPT, qui les détaille avec l'effort et le délai de chacune, et donne le plan sur 90 jours.
Questions fréquentes
ChatGPT utilise-t-il Google pour chercher ?
Indirectement. Ses requêtes internes montrent trois moteurs : « serpapi », un service tiers qui récupère les pages de résultats Google (Google l'attaque en justice pour cela), « bing-image » pour les images, et « labrador », l'index maison d'OpenAI pour le web, les actualités et Wikipedia. Une bonne position Google aide donc, sans rien garantir : ChatGPT recoupe ensuite avec ses propres sources.
Qu'est-ce que le query fan-out ?
La reformulation de votre question en plusieurs sous-requêtes envoyées aux moteurs de recherche. Ahrefs en a analysé 15 millions : une réponse sur sept déclenche une recherche, avec en moyenne 1,6 sous-requête, et des mots ajoutés comme « officiel », « prix », « avis » ou « 2026 ». C'est à ces sous-requêtes qu'une page doit répondre, pas à la question telle que l'utilisateur la tape.
Pourquoi ChatGPT cite-t-il des sources en anglais pour une question en français ?
Parce qu'il juge les pages anglaises plus faciles à évaluer : plus de liens, plus de citations, et la moitié du web est en anglais. Peec AI a mesuré que 43 % des sous-requêtes pour des questions non anglophones sont faites en anglais, et qu'au moins une sous-requête anglaise apparaît dans chaque session analysée. Une entreprise française peut être invisible alors qu'elle domine son marché.
Faut-il traduire tout son site en anglais ?
Non. Une version anglaise des deux ou trois pages clés (qui vous êtes, ce que vous faites, vos tarifs) et une mention dans un comparatif en anglais suffisent souvent. La traduction en bloc coûte cher et n'apporte rien sur les pages que ChatGPT ne cherche pas.
Les médias partenaires d'OpenAI sont-ils avantagés ?
Les données le suggèrent. Ahrefs observe que la part des partenaires parmi les 200 domaines les plus cités est passée de 7,5 % à 15,8 % entre mars et juillet 2026. En France, l'INA mesure que Le Monde, premier média français partenaire d'OpenAI, reçoit plus d'un clic sur quatre envoyé par ChatGPT vers la presse. Être cité dans ces titres compte plus qu'ailleurs.
Reddit et Wikipedia comptent-ils encore ?
Beaucoup moins qu'il y a six mois. Ahrefs mesure que Reddit est passé d'une réponse ChatGPT sur cinq à une sur 43, Wikipedia d'une sur sept à une sur 35, entre mars et septembre 2026. ChatGPT remonte à la source d'origine plutôt qu'au site qui la résume. Si votre visibilité venait de là, elle a probablement reculé.
Pour aller plus loin
Le guide complet pour apparaître sur ChatGPT reprend ces règles dans une méthode en huit leviers et un plan 90 jours. Chaque moteur a ses sources favorites : nos pages Perplexity, Gemini et AI Overviews les détaillent. Et pour voir ces règles à l'œuvre sur un marché, notre baromètre sur l'immobilier parisien montre quelles sources Perplexity lit avant de recommander une agence. Pour savoir où vous en êtes, moteur par moteur, lisez Comment mesurer sa visibilité dans les IA ?.
Sources : Ahrefs, « How ChatGPT Does Query Fan-Out », octobre 2026 (66,6 M de réponses, 15 M de sous-requêtes) et données de citations Brand Radar, mars à septembre 2026 ; Peec AI, « ChatGPT searches in English, even when you don't », 2026 (10 M de prompts, 20 M de sous-requêtes) ; INA, La Revue des médias, étude du trafic envoyé par ChatGPT vers la presse française, données SimilarWeb 2025 ; valeurs de la clé search_engine observées dans les requêtes internes de ChatGPT. Les chiffres décrivent un modèle à une période donnée et peuvent évoluer avec les mises à jour.